Ein Digital Twin ist ein digitales Modell eines physischen Systems, in dem Sie Änderungen testen, bevor Sie sie umsetzen. Die 3D-Simulationen von Stromversorgung und Kühlung für KI-Rechenzentren von NVIDIA und Schneider sind das Problem anderer. Die Variante, auf die es ankommt, ist der Network Digital Twin, ein berechenbares Modell von Switches, Firewalls und Routen. Das Problem, das er löst, ist groß: Laut Uptime Institute gehen 41 Prozent der schweren Netzwerkausfälle auf Fehler in Konfiguration und Change-Management zurück, und 87 Prozent der Ausfälle wären vermeidbar gewesen. Gartner prognostiziert 70 Prozent weniger ungeplante Ausfallzeiten für Organisationen, die Änderungen zuerst modellieren. Diese Analystenschätzung zitieren Anbieter nur allzu gern. Der Hype steckt im Begriff selbst, der inzwischen auf jede Topologiekarte geklebt wird, und in der Größenordnung. IP Fabric, Forward Networks und NetBrain sind für Organisationen mit 1.000 oder mehr Mitarbeitenden gebaut. Für MSPs ist ein Twin als eigenes Werkzeug über den gesamten Kundenstamm hinweg nutzbar, wenn drei Bedingungen erfüllt sind. Erstens kostet die erste Stufe (Konfigurations-Backups, Diffs und eine Source of Truth) keine Lizenz. Zweitens gehören nur Kunden mit mehreren Standorten, mehreren Herstellern und Compliance-Anforderungen in das Modell. Drittens lassen Sie sich vom Anbieter beweisen, dass das Modell einen echten Fehler findet, bevor Sie unterschreiben.
In diesem Artikel
Was macht ein solcher Twin eigentlich?
Der Begriff umfasst zwei Welten, die wenig miteinander zu tun haben. Die erste ist die von NVIDIA, Schneider Electric, Cadence und Siemens. Auf der GTC im März 2026 machten sie den Omniverse DSX Blueprint allgemein verfügbar, eine Plattform, mit der sich Layout, Stromtopologie und thermisches Verhalten von Gigawatt-Rechenzentren simulieren lassen, bevor der erste Spatenstich erfolgt. Das ist beeindruckend, laut dem Analysten Dell’Oro aber auch der Praxis weit voraus. Dort läuft der Großteil der Rechenzentrumsplanung noch über CAD und BIM, und die Einführung von Digital Twins steckt in den Kinderschuhen. Für einen MSP, der Kunden mit einem Serverschrank, einem Colocation-Rack oder einem Azure-Tenant betreut, ist das eine schöne Geschichte über das Problem anderer.
Die zweite Welt ist die des Network Digital Twin. Gartner beschreibt ihn als Modell des Verhaltens von Campus-, SD-WAN- oder Rechenzentrums-Netzwerkkomponenten, entweder als eigenständige Anwendung oder eingebettet in eine umfassendere Management- oder Security-Plattform. Die IETF/IRTF arbeitet seit 2022 an einer Referenzarchitektur, und im Sommer 2026 liegt das Dokument in der dreizehnten Fassung vor. Der Kern ist stets derselbe: Das Modell liest Konfiguration und Zustand echter Geräte aus, baut daraus eine berechenbare Abbildung des Netzwerks und bietet eine Sandbox, in der Sie eine Änderung oder einen Ausfall durchspielen können, ohne dass ein Anwender etwas davon merkt. Um diese Variante geht es hier.
Welches Problem löst das?
Das Problem ist alt und gut dokumentiert. In der Annual Outage Analysis 2026 des Uptime Institute, die auf einer Umfrage unter mehr als 450 Betreibern basiert, bleiben Fehler in Konfiguration und Change-Management die am häufigsten genannte Ursache schwerer Netzwerkausfälle. 41 Prozent der betroffenen Betreiber nennen sie, noch vor Störungen bei externen Netzwerkprovidern und Hardwaredefekten. Menschliche Fehler spielen bei 92 Prozent der Ausfälle zumindest eine Nebenrolle. 59 Prozent der Betreiber, bei denen ein menschlicher Fehler in der Kette lag, verweisen darauf, dass bestehende Verfahren nicht eingehalten wurden. Die unangenehmste Zahl: 87 Prozent der Betreiber, die einen folgenschweren Ausfall erlebten, sagen, dass er mit besserem Management, besseren Prozessen oder einer besseren Konfiguration vermeidbar gewesen wäre. Dieser Anteil steigt seit Jahren.
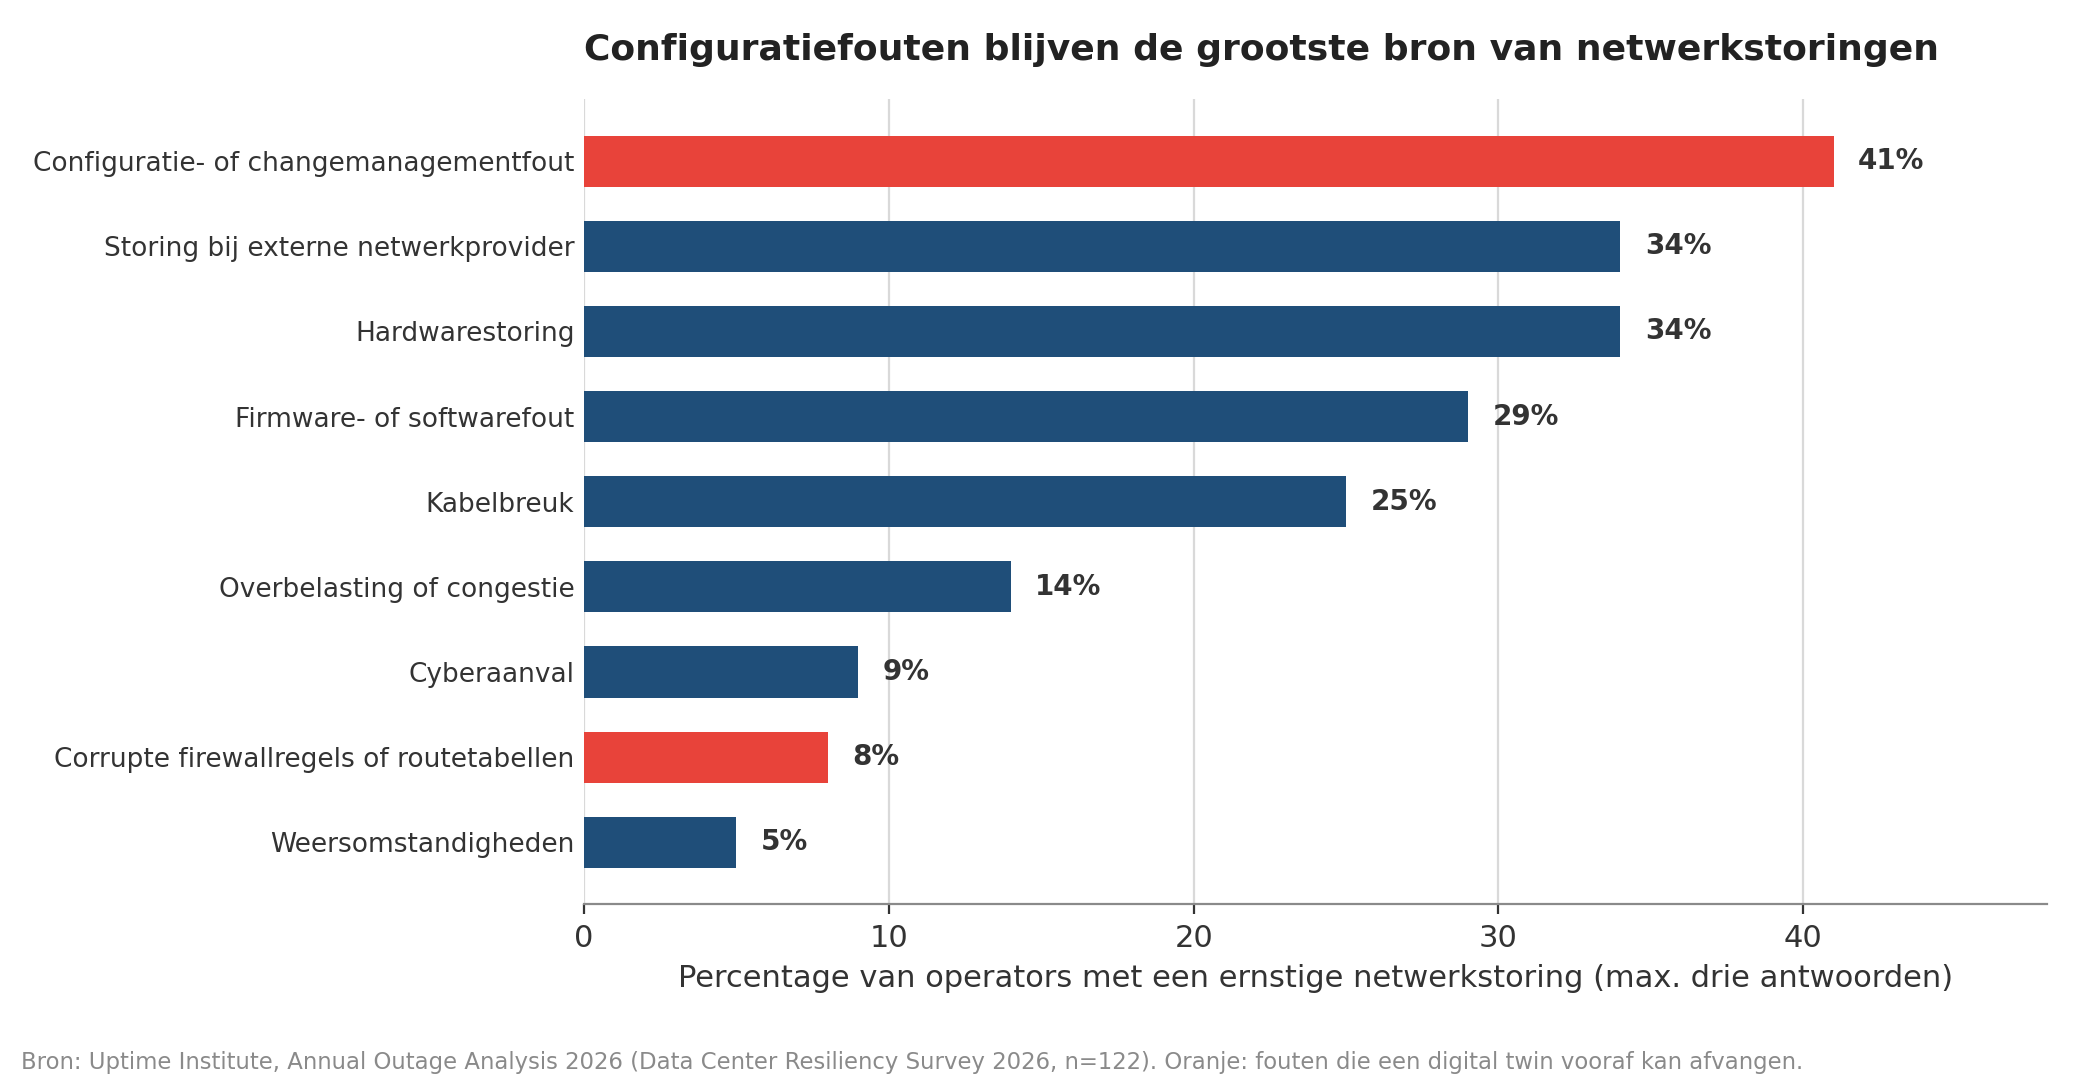
Abbildung 1: Fehler in Konfiguration und Change-Management bleiben die größte Ursache schwerer Netzwerkausfälle. Quelle: Uptime Institute, Annual Outage Analysis 2026.
Uptime stellt dabei eine Veränderung in der Art der Fehler fest. Software-defined Networking und Automatisierung machen Netzwerke flexibler und schneller wiederherstellbar. Zugleich erhöhen sie das Risiko von Konfigurationsfehlern und Kaskadeneffekten: Eine einzige falsche Regel wird von einem Automatisierungstool auf hundert Geräte gepusht. Gartner knüpft daran im Bericht Leverage Network Digital Twins to Increase Agility and Lower Risk (April 2025) eine Prognose: Organisationen, die ihre Konfigurationsänderungen und Firmware-Updates zuerst in einem Network Digital Twin modellieren, senken ihre ungeplanten Ausfallzeiten bis einschließlich 2028 um 70 Prozent. Das ist eine Analystenprognose und keine Messung, und Anbieter zitieren sie gern. Der Mechanismus dahinter ist aber plausibel: Wer eine Änderung zuerst durchrechnen lässt, fängt den Fehler ab, bevor er live geht.
Was macht ein solcher Twin eigentlich?
Es hilft, den Twin als Treppe zu betrachten statt als einzelnes Produkt. Ganz unten steht statische Dokumentation: die Visio-Zeichnung und die Excel-Liste, die an dem Tag stimmen, an dem sie erstellt wurden. Darüber liegt automatisierte Discovery, bei der ein RMM- oder Dokumentationstool die Geräte ausliest und ein Inventar pflegt. Hier stehen die meisten MSPs, und das ist kein Twin. Die dritte Stufe ist ein Snapshot-Modell: Konfiguration und Zustand werden regelmäßig festgehalten, sodass Sie vergleichen können, was sich zwischen gestern und dem Ausfall von heute Morgen geändert hat. Die vierte ist die Pfadanalyse: Das Modell berechnet, wie der Datenverkehr von A nach B läuft, über alle Switches, Firewalls und Cloud-Anbindungen hinweg. Die fünfte ist die What-if-Verifikation. Dabei spielen Sie eine Änderung im Modell ein und lassen prüfen, ob Segmentierung, Routen und Firewallregeln noch stimmen. Ganz oben steht die automatisierte Remediation, bei der das Modell die Änderung innerhalb festgelegter Leitplanken selbst ausführt.
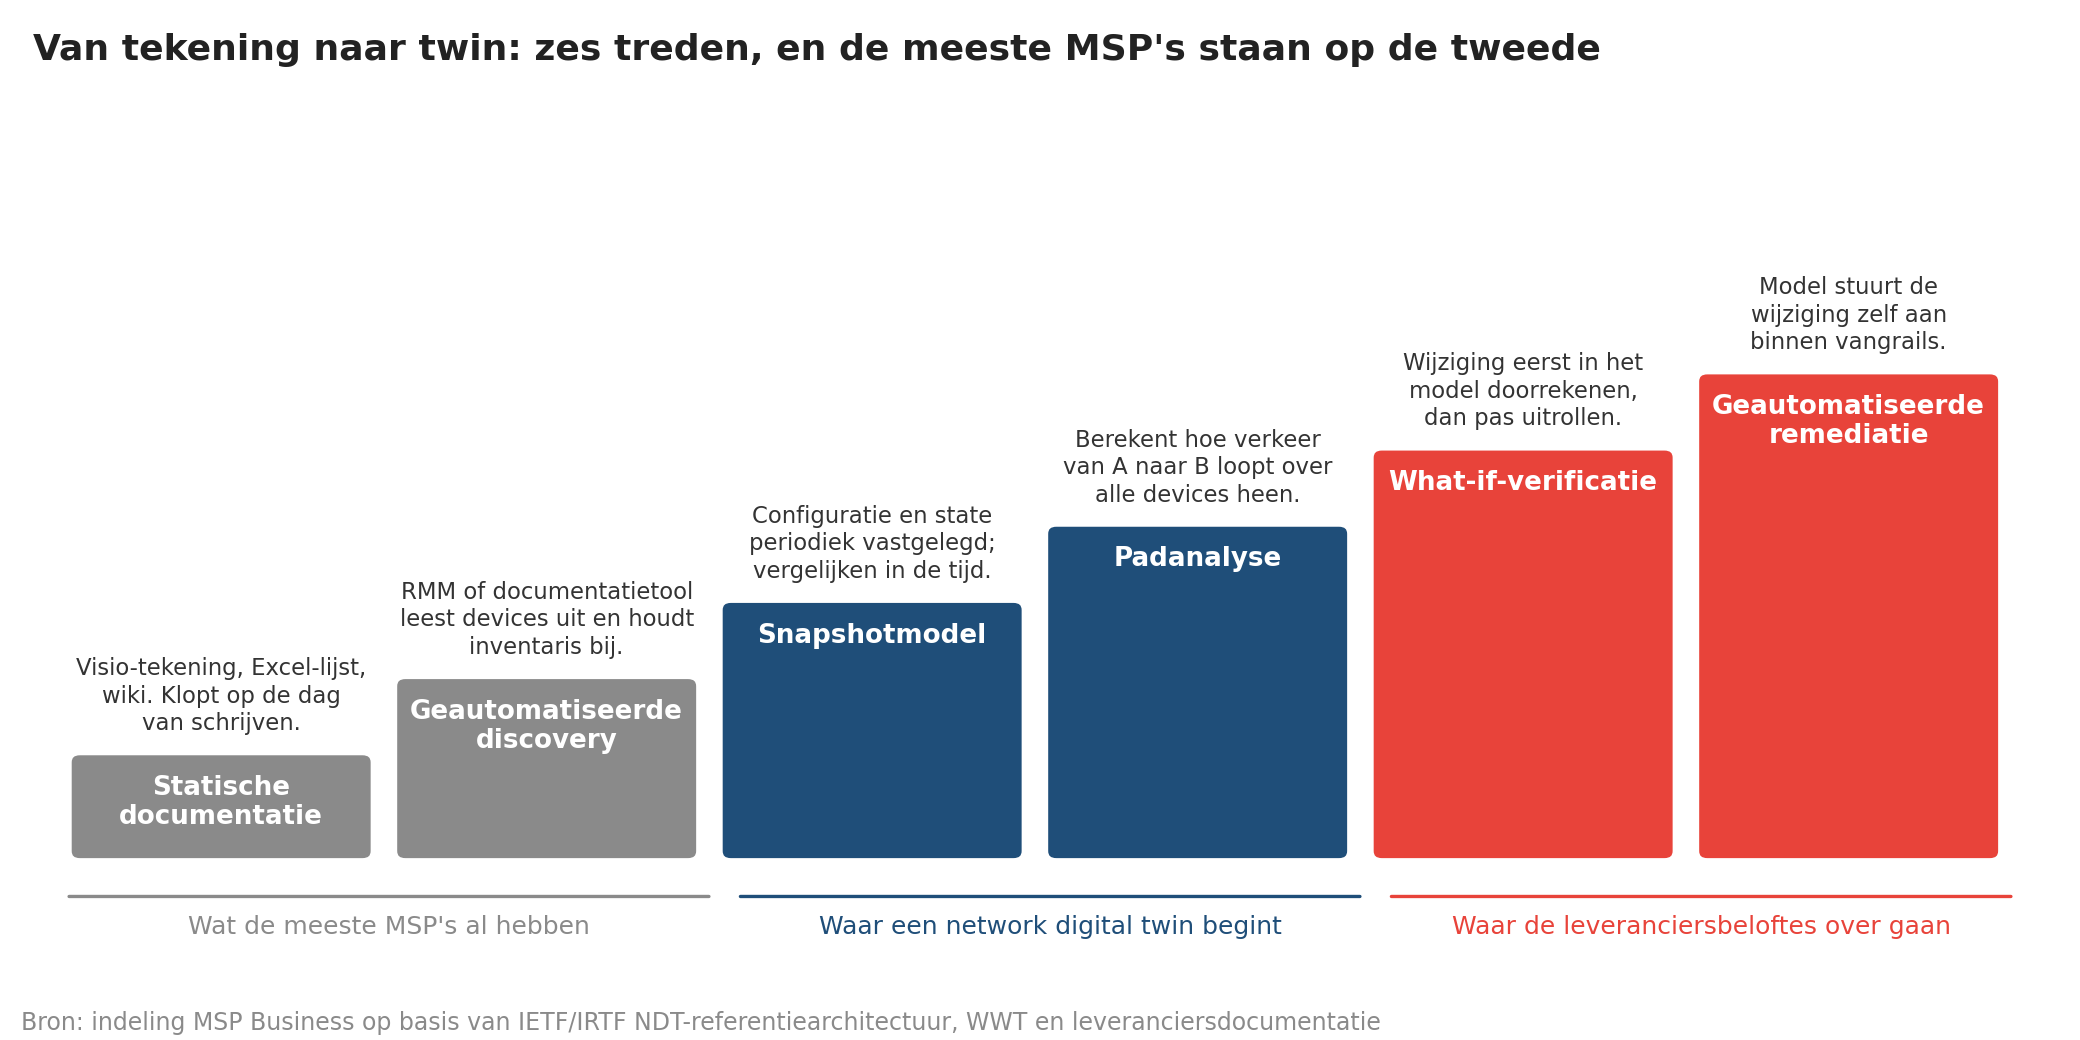
Abbildung 2: Sechs Stufen von der Dokumentation zum Digital Twin. Die meisten MSPs stehen auf der zweiten, ein Twin beginnt bei der dritten. Quelle: Einteilung MSP Business.
Die drei bekanntesten Anbieter sind jeweils auf einem anderen Abschnitt dieser Treppe angesiedelt. Das zeigt ein Vergleich, den der Integrator World Wide Technology im Januar 2026 veröffentlichte. IP Fabric arbeitet mit Read-only-Discovery und zeitgesteuerten Snapshots und liefert mehr als 150 integrierte Prüfregeln. Es ist bewusst kein Echtzeit-Monitor: Wie aktuell das Modell ist, hängt vom Discovery-Zeitplan ab. Forward Networks baut ein mathematisches Modell, das alle möglichen Pfade durchrechnet. Damit ist es bei What-if-Analysen und der formalen Verifikation der Segmentierung am stärksten, führt selbst aber keine Änderungen aus. NetBrain ist am nächsten am Tagesbetrieb, mit dynamischen Karten, No-Code-Runbooks und geschützten Change-Workflows, und nennt MSPs ausdrücklich als Zielgruppe. WWT nennt für alle drei dieselben Einschränkungen: Die Lernkurve ist steil, der Nutzen steht und fällt mit einer vollständigen und regelmäßigen Auslesung aller Geräte, und ein Modell, das nicht gepflegt wird, ist nach wenigen Wochen nur noch ein Visio-Diagramm.
Wo steckt der Hype?
Der Hype steckt in der Größenordnung, für die diese Lösungen verkauft werden, und im Begriff selbst. Forward Networks schreibt auf seiner eigenen Preisseite, dass die Plattform bei Organisationen mit in der Regel 1.000 oder mehr Mitarbeitenden läuft, und rechnet pro modelliertem Gerät ab. Zu den Referenzkunden zählen Goldman Sachs, PayPal, Vodafone und S&P Global. Ein KMU-Kunde mit zwei Switches, einer Firewall und einem Meraki-Dashboard hat kein Netzwerk, das sich zu modellieren lohnt. Dort leistet die Topologiekarte im Cloud-Portal des Herstellers bereits, was ein Twin verspricht. Für diesen Kunden ist der Digital Twin die Lösung für ein Problem, das er nicht hat.
Daneben treibt auch das Marketing den Hype. Anbieter von Monitoring-, Dokumentations- und Netzwerkautomatisierungslösungen kleben das Etikett inzwischen auf alles, was eine Topologiekarte zeichnet. Ein Tool, das Geräte ausliest und ein Bild erzeugt, steht auf der zweiten Stufe. Ein Twin beginnt bei der dritten und beweist sich erst auf der fünften, wo eine Änderung zuerst durchgerechnet wird. Erhalten Sie als MSP ein Angebot, in dem der Begriff „Digital Twin“ vorkommt, lautet die Frage also: Kann ich hier eine Änderung testen, bevor ich sie ausrolle, und was passiert, wenn sich das Ergebnis als falsch herausstellt?
Die Investitionszahlen von Uptime zeigen, wo sich der Markt tatsächlich bewegt. Rechenzentrumsbetreiber setzen 2026 häufiger auf Automatisierung und Steuerungssysteme als in den vergangenen drei Jahren, während Monitoring und Analytics, die Investition mit dem bislang größten Nutzen, leicht zurückgehen. Das ist die Ebene, auf die ein Twin gehört. Allerdings sind es Rechenzentrumsbetreiber, die das sagen, und keine mittelständischen Unternehmen mit einem Serverschrank im Hausanschlussraum.
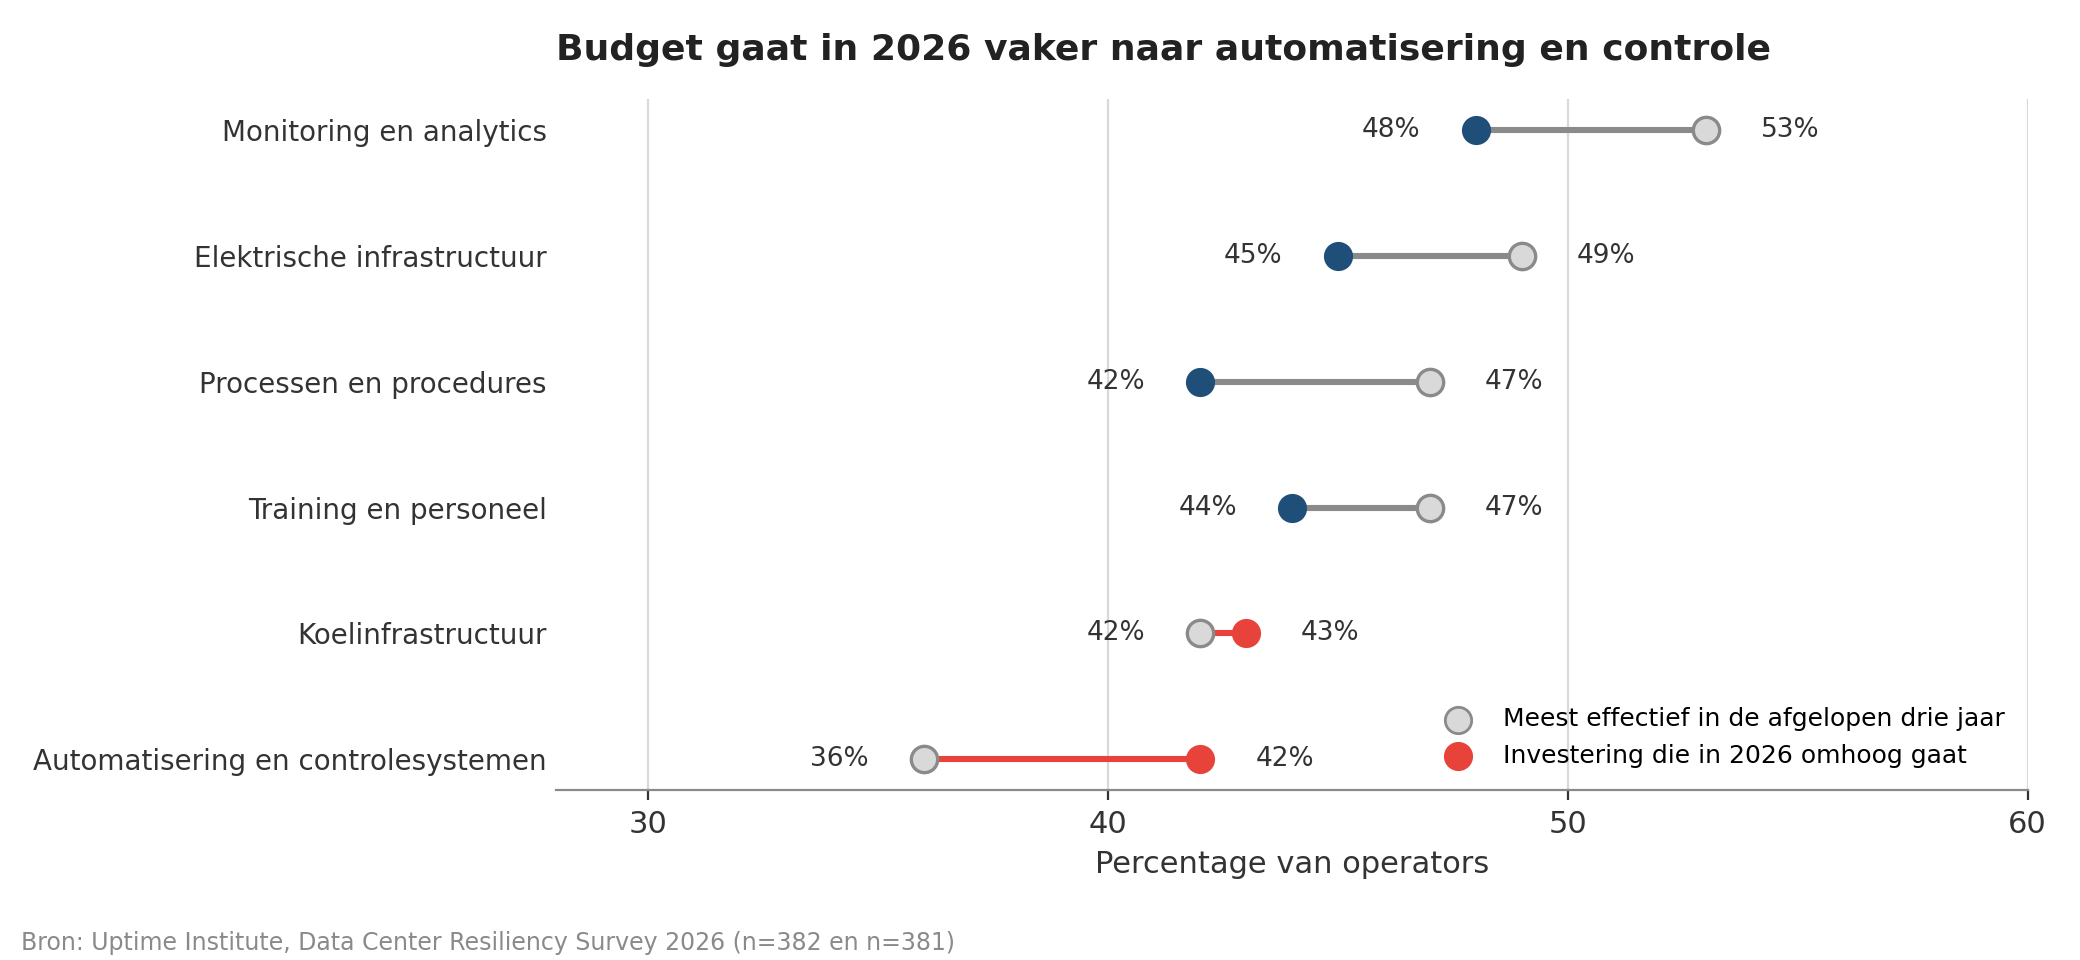
Abbildung 3: Rechenzentrumsbetreiber setzen 2026 häufiger auf Automatisierung und Steuerung. Monitoring bleibt die Investition mit dem größten Nutzen. Quelle: Uptime Institute, Data Center Resiliency Survey 2026.
Was bedeutet das für MSPs?
Das ehrliche Fazit lautet: Ein Network Digital Twin ist für MSPs nutzbar, sofern sie ihn als eigenes Werkzeug betrachten und nicht als Produkt pro Kunde. Die Größenordnung, die ein Twin braucht, liegt beim MSP und nicht beim Kunden. Ein MSP mit dreißig Kunden, fünf Netzwerkherstellern im Stack und einigen Hundert Firewalls und Switches unter Verwaltung hat genau das Multi-Vendor- und Multi-Site-Problem, für das diese Plattformen gebaut sind. Eine Modellplattform über den gesamten Kundenstamm, abgerechnet pro Gerät, ist ein anderer Business Case als ein Twin pro Kunde. So positionieren auch NetBrain und Forward ihr MSP-Angebot.
Der erste Schritt kostet keine Lizenz. Die dritte Stufe der Treppe, das Snapshot-Modell, lässt sich mit vorhandenem Tooling erreichen: automatisierte Konfigurations-Backups jedes Switches und jeder Firewall, ein Diff bei jeder Änderung und eine Source of Truth wie NetBox, in der der Sollzustand hinterlegt ist. Ein MSP, der das nicht im Griff hat, braucht kein Angebot einzuholen, denn das Modell hat nichts, was es auslesen könnte. Steht diese Basis, können Sie mit Open-Source-Netzwerkemulation wie Containerlab ein Kundennetzwerk nachbauen und ein Firmware-Update oder eine neue Firewall-Policy zuerst dort laufen lassen. Forschende veröffentlichten im Juni 2026 ein Konzept für einen solchen Low-Cost-Twin auf Basis von Open-Source-Tooling. Er ist aufwendig, und seine Zuverlässigkeit reicht nur so weit wie die virtuellen Images, die der Hersteller bereitstellt. Um eine falsche ACL abzufangen, genügt er aber.
Der zweite Schritt ist die Auswahl, denn nur eine Minderheit der Kunden gehört in das Modell. Diese Kunden haben mehrere Standorte, mehrere Netzwerkhersteller, eine Anbindung an eine Cloud-Umgebung und Compliance-Anforderungen. Die Cyberbeveiligingswet, das niederländische Gesetz zur Umsetzung von NIS2, verlangt nachweisbares Change-Management und Belege dafür, dass die Segmentierung funktioniert. Ein Twin, der pro Änderung einen Verifikationsbericht liefert, ist darauf eine praktische Antwort. Für den Installationsbetrieb mit nur einem Standort bleibt die Topologiekarte des Herstellers ausreichend.
Der dritte Schritt betrifft die Messlatte, die Sie beim Anbieter anlegen. Verlangen Sie einen Proof of Concept in einer echten Kundenumgebung mit einer echten geplanten Änderung, und prüfen Sie, ob das Modell den Fehler findet, den der Engineer selbst übersehen hat. Fragen Sie, wie oft das Modell aktualisiert wird und was mit Geräten geschieht, die es nicht auslesen kann. Und fragen Sie, was mit der Lizenz passiert, wenn der Kundenstamm um zwanzig Prozent wächst. Ein Twin, der in diesem Gespräch gute Antworten liefert, ist ein Instrument, das den MSP selbst effizienter und den Kunden zuverlässiger macht. Ein Twin, der über die Demo der Topologiekarte nicht hinauskommt, ist ein Dokumentationstool mit einem teuren Etikett.
Das Versprechen von 70 Prozent weniger ungeplanten Ausfallzeiten ist eine Analystenprognose für Großunternehmen, und die Omniverse-Simulationen von KI-Fabriken sind eine Welt, die MSPs nur von außen betrachten. Was bleibt, ist bescheidener und brauchbarer: ein Modell des Netzwerks, das eine Änderung durchrechnet, bevor sie live geht, aufgebaut in der Größenordnung des MSP, für die Kunden, bei denen ein Konfigurationsfehler wirklich wehtut. Uptime beziffert den Anteil der schweren Netzwerkausfälle, die auf einen solchen Fehler zurückgehen, auf 41 Prozent. Diese Zahl senkt der MSP eher mit einem guten Snapshot und einer Testumgebung als mit einem 3D-Modell.
Quellen: Uptime Institute, Annual Outage Analysis 2026 (Mai 2026); Uptime Institute, Pressemitteilung Annual Outage Analysis 2026; Gartner, Leverage Network Digital Twins to Increase Agility and Lower Risk (April 2025), zitiert von Forward Networks; NetBrain, Named Representative Vendor in Gartner Network Digital Twin Research (Mai 2025); World Wide Technology, Network Digital Twin Tools Comparison (Januar 2026); Forward Networks, Pricing; IETF/IRTF, Network Digital Twin (NDT): Concepts and Reference Architecture, draft-irtf-nmrg-network-digital-twin-arch-13 (Juli 2026); NVIDIA, Omniverse DSX Blueprint und Vera Rubin DSX AI Factory Reference Design (März 2026); Dell’Oro Group, GTC 2026: Moving from Chip Launches to Infrastructure Architecture (März 2026); Data Center Frontier, Schneider Electric Maps the AI Data Center’s Next Design Era (März 2026); arXiv, Building a Low-cost Network Digital Twin for the IoT-Edge-Cloud Continuum Using Open-Source Tooling (Juni 2026).
Dieser Artikel ist ursprünglich auf Niederländisch bei MSP Business erschienen. Zum Originalartikel →